
Eine KI-Suchmaschine beantwortet Fragen direkt in natürlicher Sprache und liefert dazu Quellenangaben, statt dir nur eine Liste von Links hinzuwerfen. Klingt praktisch. Aber kannst du dem Ergebnis wirklich trauen? Eine Studie des Tow Center for Digital Journalism fand heraus, dass KI-Suchmaschinen ihre Quellen im Schnitt in mehr als 60 Prozent der Fälle falsch zitieren; selbst der beste Anbieter im Test lag noch bei über einem Drittel Fehlerquote. Dieser Ratgeber vergleicht acht der meistgenutzten KI-Suchmaschinen deshalb nicht nach Tempo oder Optik, sondern danach, wie transparent sie ihre Quellen zeigen und wie oft unabhängige Studien sie beim Falschliegen erwischt haben.
Was ist eine KI-Suchmaschine?
Kurz gesagt: Eine KI-Suchmaschine ist ein Suchwerkzeug, das ein großes Sprachmodell (LLM) nutzt, um das Web zu durchsuchen und Fragen direkt in natürlicher Sprache zu beantworten, mit Quellenangaben statt einer reinen Ergebnisliste. Statt zehn blauen Links bekommst du einen zusammenhängenden Text, der auf Basis von Sprachverarbeitung (NLP) mehrere Quellen zusammenfasst und kennzeichnet, woher die einzelnen Aussagen stammen.
Genau an diesem Punkt hängt die Vertrauensfrage. Eine KI-Suchmaschine kann eine Quelle korrekt zusammenfassen, sie kann eine Aussage aber auch falsch zuordnen, veralten lassen oder schlicht erfinden, und auf den ersten Blick sieht eine falsche Quellenangabe genauso überzeugend aus wie eine richtige. Wie zuverlässig die einzelnen Anbieter dabei wirklich sind, zeigen die unabhängigen Studien im nächsten Abschnitt.
Wie wir die KI-Suchmaschinen bewertet haben
Drei Kriterien, immer in derselben Reihenfolge: Zitier-Transparenz, gemessene Genauigkeit, Zugang und Kosten. Nach genau diesem Raster bewerten wir jeden Anbieter in diesem Ratgeber.
Zitier-Transparenz fragt, ob ein Tool anklickbare Quellenangaben direkt neben jeder Behauptung zeigt, oder ob es Aussagen einfach unbelegt in den Raum stellt. Bei der gemessenen Genauigkeit zählt, ob ein Tool überhaupt in einer unabhängigen, namentlich genannten Studie getestet wurde und was dabei herauskam. Und dann noch Zugang und Kosten: Was bekommst du tatsächlich kostenlos, und was kostet die nächsthöhere Stufe Stand 2026?
Den Großteil der Beweislage für diesen Ratgeber liefern zwei Studien: die Untersuchung „AI Search Has a Citation Problem“ des Tow Center for Digital Journalism an der Columbia University, veröffentlicht im März 2025, und der Bericht „News Integrity in AI Assistants“ von BBC und European Broadcasting Union, veröffentlicht im Oktober 2025. Weiter unten zitieren wir außerdem eine Bitkom-Umfrage zum Stichwort „Dr. KI“, über die tagesschau.de berichtete, als zusätzlichen deutschen Marktdatenpunkt. Den Originalbericht von Bitkom haben wir für diesen Beitrag allerdings nicht direkt eingesehen, weshalb wir die Zahl ausdrücklich als Sekundärquelle einordnen, nicht als unabhängig verifiziert.
Übrigens ist diese Art von Quellenprüfung nicht nur für die Auswahl einer Suchmaschine relevant: Dieselbe Zitier-Transparenz-Lücke ist ein wesentlicher Grund, warum korrekt zitiert zu werden in der KI-Suche für Marken und Publisher inzwischen zu einer eigenen Disziplin geworden ist. Jedes Urteil zu den einzelnen Tools in diesem Artikel stützt sich direkt auf die beiden genannten Studien, nicht auf ungeprüfte Marketingaussagen. Eine bewusste Regel für diesen Ratgeber: keine Genauigkeitsbehauptung ohne genannte Quelle dahinter.
KI-Suchmaschine vs. traditionelle Suchmaschine

Der Kernunterschied: Eine traditionelle Suchmaschine liefert eine nach Relevanz sortierte Liste von Links, eine KI-Suchmaschine kombiniert Quellenrecherche und Textgenerierung zu einer direkten, ausformulierten Antwort. Diese Verschiebung von „hier sind mögliche Antworten“ zu „hier ist die Antwort“ verändert auch, wie ein Fehler aussieht.
Die wichtigsten Unterschiede im Überblick:
- Ergebnisformat: klassische Suche zeigt eine Linkliste, KI-Suche liefert eine zusammenhängende, direkte Antwort.
- Quellenangabe: klassische Suche verlinkt die Originalseite, KI-Suche zitiert einzelne Aussagen innerhalb des generierten Texts, teils inline, teils gar nicht.
- Aktualität: klassische Suche zeigt den jeweils aktuellen Indexstand einer Seite, KI-Suche kann veraltete oder aus dem Trainingsmaterial stammende Informationen als aktuell präsentieren.
- Verifizierbarkeit: eine Linkliste kann inhaltlich falsch sein, wenn die verlinkte Seite falsch liegt, sie kann aber nicht selbst eine falsche Tatsachenbehauptung formulieren. Eine generierte Antwort kann genau das, und zwar so, dass die Quellenangabe daneben trotzdem korrekt aussieht.
Genau dieser letzte Punkt ist der Grund, warum dieser Ratgeber überhaupt existiert: Eine Linkliste kann dich in die Irre führen, aber eine generierte Antwort kann schlicht faktisch falsch sein und dabei trotzdem wie eine geprüfte Aussage wirken.
Die besten KI-Suchmaschinen im Überblick
Wenn du nur einen Abschnitt liest, dann diesen. Die Preise sind Stand September 2026 und in US-Dollar angegeben, da die meisten Anbieter keine eigene Euro-Preisliste führen; für Deutschland kann die tatsächliche Umrechnung je nach Zahlungsanbieter leicht abweichen.
| Tool | Einstiegspreis | Am besten für | Zitier-Genauigkeit-Signal |
|---|---|---|---|
| Perplexity | Kostenlos / 20 $ Pro / 200 $ Max | Zitierte, überprüfbare Alltagsrecherche | 37 % Zitier-Fehlerrate, niedrigste von 8 getesteten Tools (Tow Center) |
| ChatGPT Search | Kostenlos / 20 $ Plus | Alltagsrecherche im gewohnten Chat-Workflow | 67 % Zitier-Fehlerrate (Tow Center), signalisiert selten Unsicherheit |
| Google AI Modus | Kostenlos (erweiterte Funktionen brauchen Google AI Pro/Ultra) | Suche, integriert in den Rest von Google | Gemini schnitt von 4 getesteten Assistenten am schlechtesten ab, 76 % Fehlerquote (BBC/EBU) |
| Microsoft Copilot | Kostenlos (Copilot Pro eingestellt, erweiterte Funktionen jetzt in Microsoft 365 Premium, 19,99 $/Monat) | Kostenlose Alltagssuche mit eingebauten Quellenangaben | Sourcing-Fehlerrate unter 25 %, zweitbestes von 4 getesteten Tools (BBC/EBU) |
| Kagi | 5 $ Starter / 10 $ Professional / 25 $ Ultimate | Datenschutzorientierte, werbefreie, nutzerfinanzierte Suche | Nicht direkt getestet in einer der beiden Studien, werbefreies Modell ohne Datenverkauf als struktureller, nicht gemessener Vertrauenswert |
| Brave Search (Leo) | Kostenlos / 14,99 $ Leo Premium | Datenschutzorientierte Suche direkt im Browser | Nicht direkt getestet in einer der beiden Studien |
| Consensus | Kostenlos (20 Suchen/Monat) / ca. 10-15 $ Pro / 45 $ Deep | Akademische und peer-reviewte Recherche | Nicht direkt getestet, Quellen stammen per Design ausschließlich aus über 200 Millionen Peer-Review-Papern |
| Grok | Kostenlos / 8 $ X Premium / 30 $ SuperGrok / 40 $ X Premium+ | Echtzeitdaten aus X/Social Media | 94 % Zitier-Fehlerrate, Grok-3, schlechtestes von 8 getesteten Tools (Tow Center) |
(Preise Stand September 2026, in USD, für Deutschland ggf. abweichende Umrechnung)
Was die Studien zur Genauigkeit von KI-Suchmaschinen zeigen
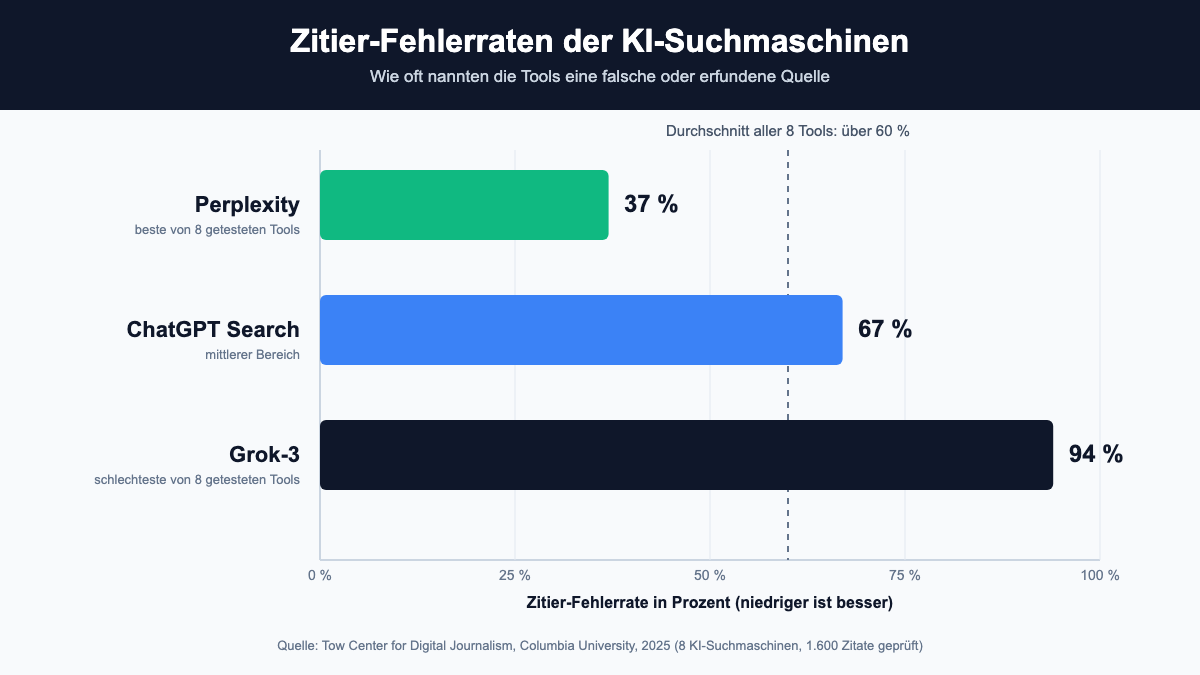
37 Prozent: So niedrig lag Perplexitys Zitier-Fehlerrate, der beste Wert aller getesteten Tools in der bislang detailliertesten unabhängigen Studie zu diesem Thema. Und schon diese eine Zahl sagt fast alles über den aktuellen Stand der KI-Suche. Selbst das beste Tool liegt noch in mehr als einem Drittel der Fälle falsch, und keines der getesteten Tools ist genau genug, um bei Aussagen, die wirklich zählen, auf eine eigene Prüfung zu verzichten.
Durchgeführt hat die Studie das Tow Center for Digital Journalism an der Columbia University. Die Forschenden gaben 1.600 direkte Auszüge aus echten Nachrichtenartikeln von 20 Verlagen in acht KI-Suchmaschinen ein (ChatGPT Search, Perplexity, Perplexity Pro, Gemini, DeepSeek Search, Grok-2, Grok-3 und Copilot) und ließen jeweils Überschrift, Verlag, Veröffentlichungsdatum und URL der Quelle bestimmen. Perplexitys kostenlose Version hatte mit 37 Prozent die niedrigste Fehlerrate. ChatGPT Search lag in 67 Prozent der Fälle falsch. Grok-3 irrte in 94 Prozent der Fälle, das schlechteste Ergebnis aller acht Tools. Im Durchschnitt über alle acht Tools waren mehr als 60 Prozent der Zitate fehlerhaft.
Der überraschendste Befund: Bezahlte Premium-Stufen schnitten nicht besser ab. Mehrere Premium-Modelle hatten sogar höhere Fehlerraten als ihre kostenlosen Gegenstücke, weil sie selbstbewusst falsche Antworten gaben, statt bei Unsicherheit einzuräumen, dass sie es nicht wussten. ChatGPT identifizierte beispielsweise 134 Artikel im Testset falsch, signalisierte dabei aber nur 15 Mal mangelnde Sicherheit. Auch Lizenzvereinbarungen lösten das Problem nicht: Selbst Verlage mit direkten Lizenzverträgen wurden häufig falsch zugeordnet oder auf Zweitveröffentlichungen statt auf das Original verlinkt. Ein besonders aufschlussreiches Detail: Perplexity identifizierte 30 Prozent der Auszüge aus National Geographic korrekt, obwohl National Geographic zu diesem Zeitpunkt den Crawler von Perplexity aktiv blockierte, ein Hinweis darauf, dass diese Tools Inhalte manchmal über Kanäle beziehen, die der Publisher weder beabsichtigt noch kontrollieren kann.
Eine zweite, größer angelegte Studie bestätigt dieses Muster über den reinen Nachrichten-Zitier-Test hinaus. BBC und European Broadcasting Union veröffentlichten im Oktober 2025 „News Integrity in AI Assistants“, die bislang größte Studie dieser Art: 22 öffentlich-rechtliche Medienhäuser aus 18 Ländern, in 14 Sprachen, ließen Fachjournalisten mehr als 3.000 reale Antworten von ChatGPT, Copilot, Gemini und Perplexity nach Genauigkeit, Quellenlage und Kontext bewerten. Fünfundvierzig Prozent aller Antworten hatten mindestens ein signifikantes Problem. Einunddreißig Prozent hatten ein ernsthaftes Quellenproblem, meist eine Information, die einer Nachrichtenquelle zugeschrieben wurde, die darüber nie berichtet hatte. Zwanzig Prozent enthielten einen gravierenden Genauigkeitsfehler, darunter erfundene Details und veraltete Informationen, die als aktuell dargestellt wurden. Gemini schnitt mit deutlichem Abstand am schlechtesten ab: 76 Prozent seiner Antworten hatten ein signifikantes Problem, mehr als doppelt so oft wie bei den anderen drei Assistenten, getrieben vor allem von einer Sourcing-Fehlerrate von 72 Prozent.
Warum passiert das? Kurz gesagt sind diese Tools nur so genau wie der Rechercheschritt, der ihre Antwort im tatsächlichen Quelltext verankert. Findet ein Tool die richtige Textstelle und gibt sie originalgetreu wieder, hält die Antwort meist stand. Paraphrasiert es stattdessen aus dem Gedächtnis, vermischt zwei Quellen oder kann die zitierte Seite gar nicht wirklich aufrufen, sieht die Quellenangabe auf dem Bildschirm identisch aus wie eine korrekte, die zugrunde liegende Aussage kann aber falsch, veraltet oder dem falschen Medium zugeschrieben sein. Weder die acht Tools der Tow-Center-Studie noch die vier der BBC/EBU-Studie zeigen dir zuverlässig, welcher der beiden Fälle gerade vorliegt.
Ein zusätzlicher, wenn auch nur qualitativer Hinweis speziell für den deutschen Markt: Laut einer Bitkom-Umfrage, über die tagesschau.de berichtete, fragen immer mehr Menschen in Deutschland KI-Assistenten wie einen digitalen Ratgeber, umgangssprachlich auch „Dr. KI“ genannt, um Rat bei Alltagsfragen. Eine belastbare, direkt verifizierte Prozentzahl dazu liegt uns für diesen Beitrag nicht vor, das grundsätzliche Bild einer wachsenden Nutzung passt aber zu den internationalen Befunden oben: KI-Assistenten werden immer öfter wie eine Suchmaschine oder ein Berater genutzt, ohne dass die zugrunde liegende Zitiergenauigkeit mitgewachsen wäre.
Perplexity: Die beste Gesamtlösung für zitierte, überprüfbare Antworten
Perplexity führt diesen Vergleich klar an: 37 Prozent Zitier-Fehlerrate in der Tow-Center-Studie, der niedrigste Wert von allen acht getesteten Tools, gegenüber 67 Prozent bei ChatGPT Search und 94 Prozent bei Grok-3. Jede faktische Aussage in einer Perplexity-Antwort trägt außerdem eine nummerierte Inline-Quellenangabe, die direkt zur Quellseite verlinkt; das macht eine Stichprobenprüfung schnell, selbst wenn die Aussage am Ende falsch war.
Die kostenlose Version deckt unbegrenzte Grundsuche mit Quellenangaben ab. Pro (20 Dollar im Monat) bringt mehr Suchanfragen, Datei-Uploads und Zugriff auf eine breitere Modellauswahl. Max (200 Dollar im Monat) richtet sich an Power-User: Es hebt das Labs-Abfragelimit auf, bringt Perplexity Computer (eine Orchestrierungsschicht, die komplexe Aufgaben auf rund 19 Spezialmodelle verteilt) und Model Council, das eine Anfrage gleichzeitig über drei Spitzenmodelle laufen lässt und zeigt, wo sie übereinstimmen oder abweichen, genau die Art Werkzeug, die für Faktenchecks im Sinne dieses Ratgebers nützlich ist.
Wo es schwächelt: Selbst Perplexitys 37 Prozent Fehlerrate bedeuten, dass mehr als jede dritte Antwort eine eigene Überprüfung braucht, bevor du dich bei etwas Wichtigem darauf verlässt. Das ist kein Freifahrtschein, sondern nur der beste Wert im Vergleich. Außerdem stützt sich das Tool bei aktuellen oder meinungslastigen Anfragen stark auf Reddit als Quelle, nützlich für Stimmungsbilder, aber kein Ersatz für eine Primärquelle.
ChatGPT Search: Am besten für Alltagsrecherche im gewohnten Chat-Assistenten
Wer ohnehin für andere Aufgaben in ChatGPT arbeitet, hat mit ChatGPT Search die Recherche gleich in derselben Oberfläche, praktisch. Das Genauigkeitsprofil solltest du dabei trotzdem kennen: 67 Prozent Zitier-Fehlerrate in der Tow-Center-Studie, dazu ein Muster, eher selbstbewusst zu antworten als Unsicherheit zu signalisieren. Nur 15 Signale geringer Konfidenz standen 149 falschen Antworten im selben Test gegenüber.
Die kostenlose Version umfasst unbegrenzte Text-Chats auf OpenAIs aktuellem Basismodell inklusive eingebauter Suche, allerdings mit engeren Grenzen bei Uploads, Sprachfunktion und Deep Research. Plus (20 Dollar im Monat) schaltet die volle Reasoning-Modellpalette, erweiterte Deep-Research-Läufe und insgesamt höhere Nutzungsgrenzen frei. Die Pro-Stufen setzen preislich noch höher an und richten sich eher an intensive Rechercheaufgaben und Coding-Workloads als an die reine Suche.
Wo es schwächelt: Quellenangaben sind inkonsistent. Mal sind sie vorhanden und überprüfbar, mal fehlen sie komplett, selbst wenn das Modell aktiv im Web recherchiert. Wenn du eine klickbare, überprüfbare Quelle brauchst, solltest du dich nicht darauf verlassen, dass ChatGPT Search sie automatisch liefert.
Google KI-Modus (AI Mode): Ist er in Deutschland kostenlos verfügbar?
Ja, die Kernfunktion des Google KI-Modus ist kostenlos, nur erweiterte Funktionen wie Deep Search brauchen ein Google AI Pro- oder AI Ultra-Abo. Aktiviert wird der KI-Modus einfach über den entsprechenden Tab in der Google-Suche, sobald er für dein Konto freigeschaltet ist. Google hat den kostenlosen Zugang bis zum Google I/O 2026 auf rund 200 Länder ausgeweitet, Deutschland eingeschlossen.
Technisch ist der Google KI-Modus die konversationelle Ebene, die inzwischen fest in die Google-Suche integriert ist: Er läuft auf einem Gemini-Modell und stützt sich auf Googles eigenen Suchindex, den Knowledge Graph und den Shopping Graph. Bei etwas komplexeren oder personalisierten Anfragen, etwa Deep Search, stößt die kostenlose Version an ihre Grenze und verlangt ein Abo.
Wo es schwächelt: In der BBC/EBU-Studie war Gemini mit deutlichem Abstand der schwächste der vier getesteten Assistenten, mit einer Fehlerquote von 76 Prozent gegenüber deutlich unter der Hälfte bei den anderen, getrieben fast ausschließlich durch Quellenfehler, 72 Prozent von Geminis Antworten hatten ein Sourcing-Problem. Wenn du den KI-Modus für irgendetwas Nachrichtennahes nutzt, solltest du die angezeigte Quelle als Ausgangspunkt für eine eigene Prüfung behandeln, nicht als fertige Antwort.
Microsoft Copilot: Die beste kostenlose Option mit eingebauten Quellenangaben
Kostenlos, mit webbasierten, quellenbelegten Antworten und anklickbaren Zitaten: Das bietet die Verbraucherversion von Copilot schon in der Gratis-Stufe, ganz ohne Kosten. In der BBC/EBU-Studie schnitt sie als zweitbester der vier Assistenten ab, mit einer Sourcing-Fehlerrate unter 25 Prozent, weit vor Geminis 72 Prozent.
Ein Hinweis für alle, die Copilot schon länger kennen: Copilot Pro, das frühere Verbraucher-Upgrade für 20 Dollar im Monat, wurde eingestellt. Es schloss Ende 2025 für Neuanmeldungen und der Support für bestehende Abonnenten endete am 1. August 2026. Die damals angebotenen erweiterten Funktionen stecken jetzt in Microsoft 365 Premium für 19,99 Dollar im Monat, das gleichzeitig Copilot in Word, Excel und die restlichen Office-Apps einbindet.
Wo es schwächelt: Copilot ist eine solide, kostenlose, ordentlich mit Quellen belegte Option, aber weder in der einen noch in der anderen Studie das genaueste Tool, und die Einstellung von Copilot Pro bedeutet, dass alte Preisvergleiche mit „Copilot Pro“ inzwischen ein eingestelltes Produkt beschreiben.
Kagi: Am besten für Datenschutz und nutzerfinanzierte, werbefreie Suche
Bei Kagi ist Vertrauen anders aufgebaut als bei den meisten Wettbewerbern: Statt werbefinanziert oder datenmonetarisiert zu sein, ist es eine bezahlte, nutzerfinanzierte Suchmaschine ohne Werbung und ohne Tracking. Kagi Assistant, die KI-Ebene des Dienstes, war in keiner der beiden Studien dabei, eine unabhängige Zitier-Genauigkeitszahl gibt es deshalb nicht. Das Geschäftsmodell selbst ist aber schon ein struktureller Vertrauensfaktor, weil Kagi keine Beziehung zu Werbetreibenden oder Datenkäufern hat, die beeinflussen könnte, was dir angezeigt wird.
Preislich beginnt Starter bei 5 Dollar im Monat (300 Suchen), Professional bei 10 Dollar im Monat (unbegrenzte Suchen, Kagi Assistant im Quick-Modus), und Ultimate bei 25 Dollar im Monat, das den Research-Modus von Kagi Assistant freischaltet, mit Zugriff auf eine Auswahl an Spitzenmodellen wie Claude, GPT, Gemini, DeepSeek und Mistral. Nicht genutzte monatliche Suchkontingente verfallen nicht, sondern werden als Guthaben mitgenommen.
Wo es schwächelt: Es gibt keine dauerhaft kostenlose Version, nur eine Testphase mit 100 Suchen, und weil Kagi nicht Teil der großen Genauigkeitsstudien war, vertraust du eher dem datenschutzfreundlichen Design als einer gemessenen Genauigkeitszahl.
Brave Search (Leo): Am besten fest im datenschutzfreundlichen Browser integriert
Direkt im Brave-Browser eingebaut und komplett kostenlos: Leo ist Braves KI-Assistent, mit einer Datenschutzarchitektur, die Anfragen über einen Proxy leitet, der identifizierende Informationen entfernt, bevor sie das Modell erreichen, ganz ohne Kontopflicht. Zusammenfassungen, Übersetzungen und Frage-Antwort-Funktionen für Webseiten, PDFs und Dokumente, die du bereits geöffnet hast, übernimmt es gleich mit.
Die kostenlose Version bietet vollen Chat-Zugriff über mehrere offene und schlanke Modelle. Leo Premium (14,99 Dollar im Monat) schaltet größere, leistungsfähigere Modelle und höhere Nutzungsgrenzen frei.
Wo es schwächelt: Wie Kagi war Leo bei keiner der beiden zentralen Genauigkeitsstudien dabei, weshalb es keine unabhängige Zitier-Fehlerzahl dazu gibt. Es ist eine wirklich private Option, aber „privat“ und „genau“ sind zwei verschiedene Eigenschaften, und hier ist nur die erste tatsächlich belegt.
Consensus: Am besten für akademische und peer-reviewte Recherche
Über 200 Millionen peer-reviewte Fachartikel, durchsucht statt des offenen Webs: Consensus ist das einzige Tool auf dieser Liste, das für eine derart enge Aufgabe gebaut wurde. Ein LLM fasst die Ergebnisse mit Quellenangaben zu den jeweiligen Studien zusammen. Für akademische oder wissenschaftliche Fragen ist dieser enge Fokus selbst schon ein Genauigkeitsvorteil, weil jede mögliche Quelle bereits ein Peer-Review-Verfahren durchlaufen hat.
Die kostenlose Version umfasst 20 KI-gestützte Suchen im Monat. Bezahlpläne liegen bei etwa 10 bis 15 Dollar im Monat für Pro (unbegrenzte Suche plus ein monatliches Kontingent an tieferen „Deep Review“-Berichten) bis zu 45 Dollar im Monat für die Deep-Stufe, mit Rabatten für verifizierte Studierende, Lehrende und klinisches Personal.
Wo es schwächelt: Es ist keine allgemeine Suchmaschine, und es war bei keiner der beiden zentralen Genauigkeitsstudien dabei, weshalb sich seine Genauigkeitsversprechen eher auf das Quellendesign als auf eine unabhängige Messung stützen. Wenn deine Frage nicht akademisch ist, ist das nicht das richtige Werkzeug.
Grok: Am besten für Echtzeit-Social-/X-Daten, schwächster Wert bei der Zitiergenauigkeit
Echtzeitnaher Zugriff auf X-Konversationen (ehemals Twitter) ist Groks große Stärke, nützlich, um eine sich entwickelnde Nachrichtenlage oder öffentliche Stimmung live zu verfolgen. Wer eher einen allgemeinen Chat-Assistenten sucht als ein zitierfokussiertes Suchwerkzeug, findet einen ausführlicheren Vergleich in unserem Ratgeber zu ChatGPT-Alternativen. Diese Echtzeit- und Social-First-Ausrichtung ist vermutlich auch der Grund, warum Grok das schlechteste Zitier-Genauigkeitsergebnis aller Tools in der Tow-Center-Studie erzielte: Grok-3 lag in 94 Prozent der Fälle falsch, wenn es Überschrift, Verlag, Datum und URL eines Nachrichtenartikels korrekt bestimmen sollte.
Grok ist kostenlos nutzbar über grok.com oder die X-App, mit Nutzungsgrenzen. Bezahlter Zugang läuft über zwei Schienen: Über X selbst gibt X Premium (8 Dollar im Monat) leichten Grok-Zugriff, X Premium+ (40 Dollar im Monat) bringt vollen Zugriff. Direkt über grok.com ist SuperGrok (30 Dollar im Monat) der eigenständige Weg zur vollen Grok-Leistung, mit SuperGrok Heavy (300 Dollar im Monat) als oberster Stufe für die höchsten Nutzungskontingente.
Wo es schwächelt: Wenn dir Zitiergenauigkeit bei Nachrichten oder Faktenfragen wichtig ist, ist das schlicht das Tool, dem die Studienlage am wenigsten vertraut, von allen acht getesteten. Nutze es für Echtzeit-Beobachtung sozialer Netzwerke, nicht für etwas, das du selbst als Quelle zitieren musst.
Wie du die richtige KI-Suchmaschine für dich auswählst
- Wenn du möglichst überprüfbare Alltagsantworten willst: nutze Perplexity. Es hat den besten gemessenen Zitier-Genauigkeitswert aller getesteten Tools.
- Wenn du ohnehin für andere Aufgaben in ChatGPT arbeitest: ChatGPT Search ist praktisch, aber überprüfe Wichtiges selbst, angesichts der 67 Prozent Zitier-Fehlerrate.
- Wenn du Suche direkt in Google eingebettet willst: Der Google KI-Modus ist kostenlos und tief integriert, prüfe Quellenangaben aber selbst nach, angesichts von Geminis schwachem BBC/EBU-Ergebnis.
- Wenn du eine kostenlose Option mit solider Quellenlage willst: Microsoft Copilot ist die stärkste kostenlose Wahl unter den großen Assistenten.
- Wenn dir Datenschutz und ein werbefreies, nutzerfinanziertes Modell am wichtigsten sind: wähle Kagi oder Braves Leo.
- Wenn deine Frage akademisch oder wissenschaftlich ist: nutze Consensus, das ausschließlich peer-reviewte Literatur zitiert.
- Wenn du Echtzeit-Social-/X-Daten brauchst und Behauptungen selbst prüfen kannst: Grok ist dafür nützlich, aber nicht für etwas, das du als gesicherte Tatsache zitieren musst.
FAQ
Ist irgendeine KI-Suchmaschine zu 100 Prozent genau?
Nein, und das nicht mal annähernd. In der bislang detailliertesten unabhängigen Studie reichten die Zitier-Fehlerraten über acht Tools von 37 Prozent (Perplexity, der beste Wert) bis 94 Prozent (Grok-3, der schlechteste Wert), bei einem Gesamtdurchschnitt von über 60 Prozent. Die Antwort jeder KI-Suchmaschine solltest du als Ausgangspunkt für eine eigene Prüfung behandeln, nicht als fertige, zitierfähige Tatsache.
Gibt es eine kostenlose KI-Suchmaschine, die wirklich genau ist?
Perplexitys kostenlose Version bietet dasselbe zitier-transparente Format wie die Bezahlstufen und hat die niedrigste gemessene Fehlerrate aller getesteten Tools. Auch die kostenlose Version von Microsoft Copilot ist eine ordentliche Option, mit einer Sourcing-Fehlerrate unter 25 Prozent in der BBC/EBU-Studie, deutlich vor Geminis 72 Prozent.
Ist die Google-KI kostenlos und wie aktiviere ich sie?
Ja: Die grundlegende Suchfunktion ist kostenlos und in Deutschland verfügbar. Du aktivierst sie über den KI-Modus-Tab in der Google-Suche, sobald er für dein Konto freigeschaltet ist. Nur erweiterte Funktionen wie Deep Search brauchen ein kostenpflichtiges Google AI Pro- oder AI Ultra-Abo. Den kostenlosen Zugang hatte Google bis zum Google I/O 2026 bereits auf rund 200 Länder ausgeweitet.
Was ist der Unterschied zwischen einer KI-Suchmaschine und Googles AI Overviews?
AI Overviews ist eine Zusammenfassungsbox, die bei manchen Suchanfragen oberhalb der klassischen Suchergebnisse erscheint. Der Google KI-Modus dagegen ist eine vollständig konversationelle Sucherfahrung, die die klassische Ergebnisseite komplett durch eine Chat-Oberfläche ersetzt, gestützt auf Googles Suchindex, Knowledge Graph und Shopping Graph. Genau diese Kombination aus KI-Modus und Gemini wurde auch in der BBC/EBU-Studie getestet, auf die sich dieser Ratgeber durchgehend bezieht.
Warum identifizierte Perplexity Inhalte eines Publishers korrekt, der seinen Crawler blockiert hatte?
In der Tow-Center-Studie identifizierte Perplexity 30 Prozent der Auszüge von National Geographic korrekt, obwohl National Geographic den Crawler von Perplexity zu diesem Zeitpunkt aktiv blockierte. Das deutet darauf hin, dass diese Tools Inhalte gelegentlich über andere Kanäle beziehen, etwa Syndizierungspartner oder zwischengespeicherte Kopien, die der ursprüngliche Publisher weder beabsichtigt noch vollständig kontrollieren oder prüfen kann.
Gibt es Copilot Pro noch?
Nein. Copilot Pro, das frühere Verbraucher-Upgrade für 20 Dollar im Monat, schloss Ende 2025 für Neuanmeldungen, und der Support für bestehende Abonnenten endete am 1. August 2026. Die damaligen erweiterten Funktionen stecken jetzt in Microsoft 365 Premium für 19,99 Dollar im Monat.
